Språkteknologi og kunstig intelligens har gjort sitt inntog i offentlig sektor, noe som skaper nye muligheter, men også utfordringer. Hvilke språkmodeller bruker vi, og til hvilke oppgaver? Hvordan kan rettssikkerhet ivaretas dersom vi overlater saksbehandling, rettskildesøk og beslutninger til teknologien? Hvem skal ta de retningsgivende valgene og hvordan sikres borgernes mulighet til innflytelse? Og hva betyr åpenhet i utviklingen av språkmodeller? Onsdag 11. februar inviterte Digital Velferdsstat til seminaret «Språkteknologi, rettsstat og demokrati» i Gamle Festsal på Domus Academica for å diskutere noen av disse høyaktuelle spørsmålene.
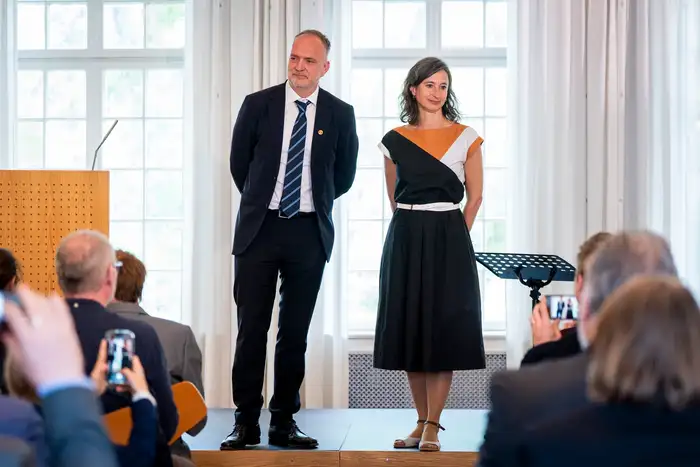
Til å geleide oss gjennom dagen hadde vi med en av lederne for Digital Velferdsstat, førsteamanuensis Jon Christian Fløysvik Nordrum. Nordrum startet med å ønske alle velkommen og presentere første innleder.
Nasjonalarkivar Inga Bolstad holdt innledningsforedrag. Bolstad pekte på koblingen mellom arkivering og rettssikkerhet, og trakk frem viktigheten av å bevare tillit, åpenhet og etterprøvbarhet i utviklingen av KI og språkmodeller.
Store språkmodeller
Bolstads innledende betraktninger beredte grunnen for seminarets første hoveddel om demokratisk legitimitet og åpenhet rundt utviklingen av språkmodeller. Gjennom fem foredrag fikk deltakerne innblikk i hvordan språkmodeller kan trenes og brukes på en ansvarlig, åpen og etisk måte.
Fra et nasjonalt perspektiv er det avgjørende med gode, norske språkmodeller. Dette var sentralt i foredraget til Javier de la Rosa, seksjonsleder for IT Språkmodeller ved Nasjonalbiblioteket. Med Nasjonalbibliotekets omfattende digitale dokumentsamling, har de vært ledende i å trene KI på norsk. Innlegget ga derfor et godt innblikk i hvordan de jobber for å utvikle nasjonale, uavhengige og trygge språkmodeller.
Videre forklarte Andrey Kutuzov, førsteamanuensis i språkteknologigruppen på Institutt for informatikk ved UiO, hva åpne språkmodeller er. Viktigheten av dette ble illustrert ved å kontrastere med lukkede systemer som er umulig å etterprøve eller sammenligne kvalitativt om som samler makt på få hender.
Sentrale etiske aspekter ved språkteknologi kom særlig frem i foredraget til Janne Petroons, stipendiat fra KU Leuven, som forsker på bruk av KI i helsesektoren i Belgia. Alex Moltzau fra KI Norge fokuserte på ansvarlig og innovativ KI-bruk i privat og offentlig sektor.
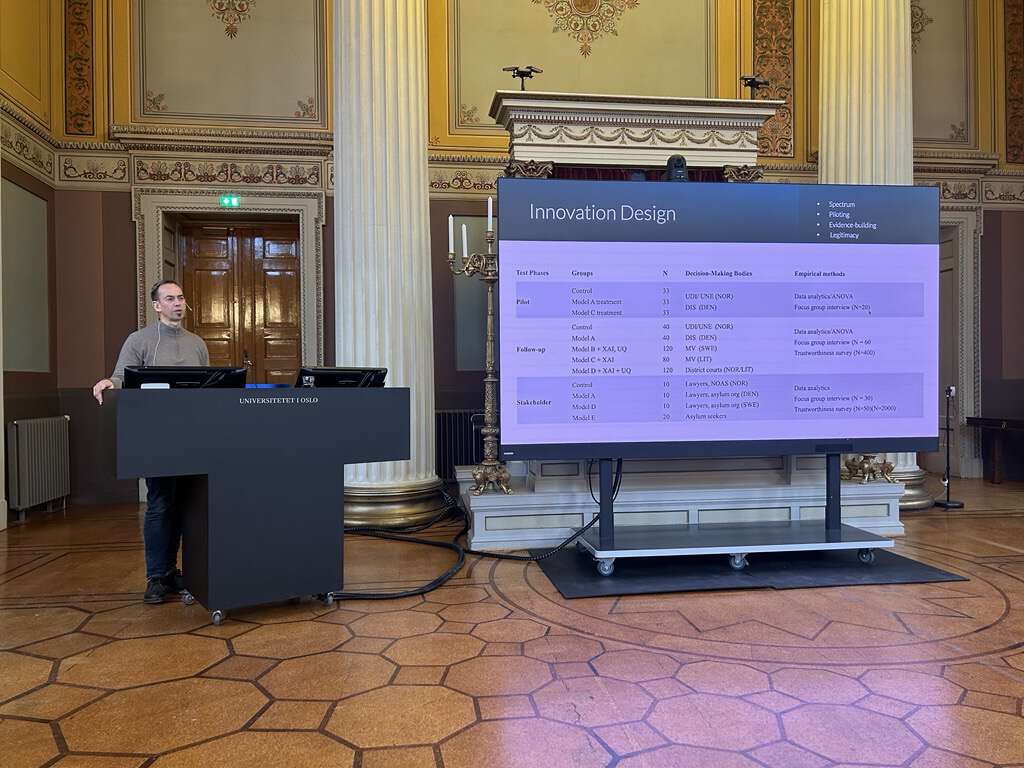
Siste talere før lunsj var professor Malcolm Langford ved Institutt for offentlig rett og førsteamanuensis Runar Hilleren Lie fra BI. De presenterte sitt prosjekt med forskning på tillitsfull bruk av KI i domstolen og offentlig forvaltning. Foredragsholderne pekte på utfordringer med åpenhet og kontroll, menneskelig tilstedeværelse og tydelig regulering.
Evaluering
Med en større forståelse av grunnlaget for språkmodellene, ble fokuset rettet mot evaluering av disse. Lilje Øvrelid, professor i forskningsgruppen for språkteknologi ved UiO, viste hvordan de arbeider for å få systematisk kunnskap om hvordan språkmodeller fungerer, lære av erfaringer og forbedre modellene. Med evalueringsprosjektet NorEval som utgangspunkt, viste Øvrelid hva som allerede er gjort, men hun pekte også på behovet for mer data og ressurser for å forbedre evalueringen av norske språkmodeller.
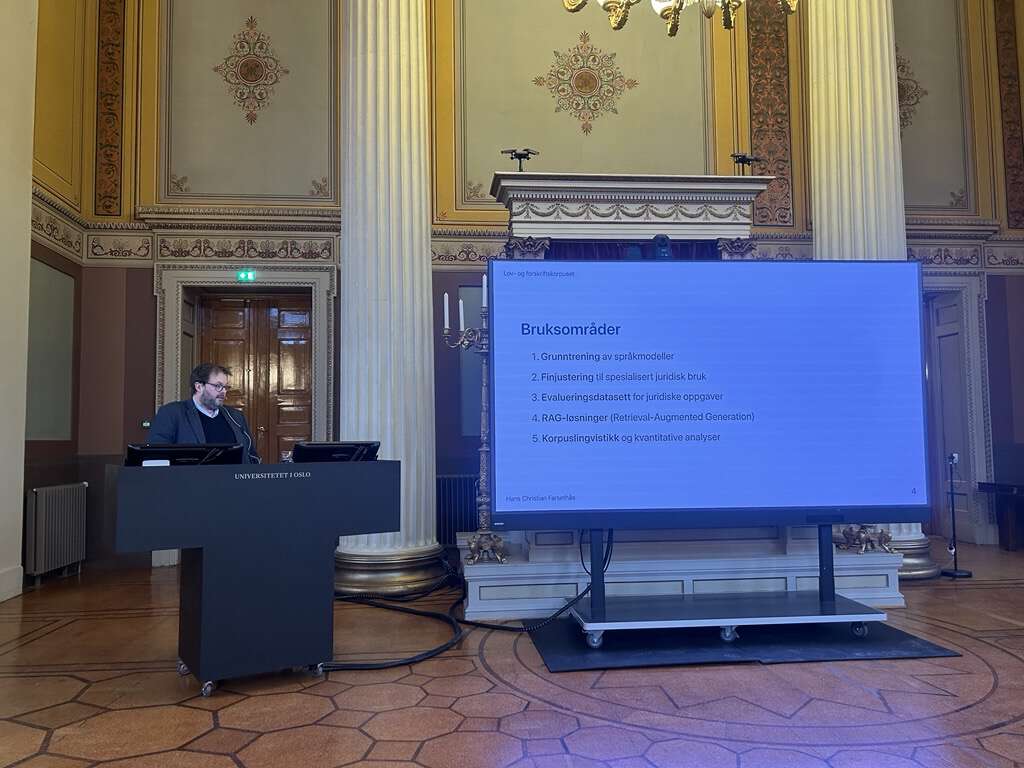
Deretter fortsatte professor Anders Løvlie og forsker Hans Christian Farsethås med en analyse av mulighetene for semantiske søk i rettskilder. Bakgrunnen for foredraget var Lovdatas nye KI-søk og foredragsholdernes analyse av søkemotoren. Et hovedproblem for KI-søk etter rettskilder er, ifølge Løvlie og Farsethås, at det er stor avstand mellom det som i teknologien kalles «semantisk» søk og det jurister vanligvis oppfatter med «semantikk». I møtet med juridiske tekster kommer denne teknologien raskt til kort. Innlegget ble etterfulgt av en kommentar fra data scientist for Lovdata, Atle Oftedahl.
Språkmodeller i offentlig sektor
Temaet for siste bolk av seminaret var språkmodeller i offentlig sektor. Hans Christian Farsethås tok igjen ordet. Han analyserte hvordan Lovdatas åpne korpus av lover og forskrifter gir nye muligheter for utvikling av norske språkmodeller, samtidig som han påviser strukturelle og semantiske utfordringer. Dette reiser også nye spørsmål for lov- og forskriftsteknikk og -praksis. Foredraget ble etterfulgt av en kommentar fra Magnus Breder Birkenes fra Nasjonalbiblioteket.
Deretter var tema bruk av språkmodeller i Nav. Data scientist Robindra Prabhu og sjefsinformasjonsarkitekt Daniel Engehagen holdt foredrag om Navs arbeid med å utvikle egne modeller som ivaretar personopplysninger, samt databaser som sikrer god forberedelse og behandling av saker.
Videre pratet Jan Roar Beckström, avdelingsdirektør i Riksrevisjonen, om Riksrevisjonens egen bruk av språkmodeller og Riksrevisjonens tanker om revisjon av forvaltningens bruk av språkmodeller.
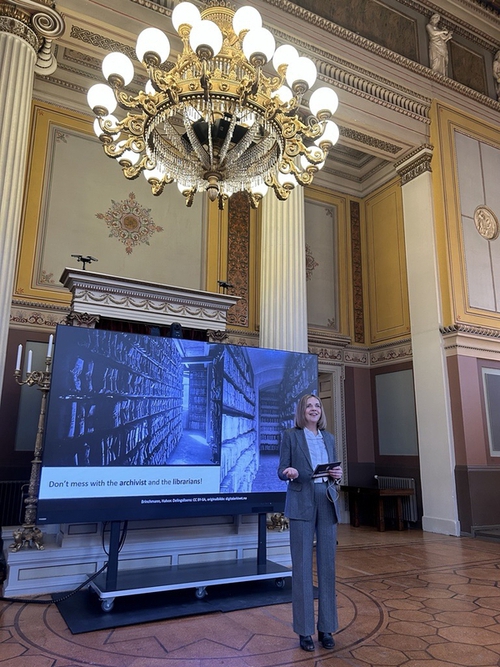
Til slutt holdt Kristin Jacobsen, avdelingsdirektør i Nasjonalarkivet innlegg der hun blant annet pekte på at arkivloven gir en plikt til å dokumentere arkiverdig materiale som spinner ut av virksomhetens praksis med språkmodellene. Hun demonstrerte også hvordan Nasjonalarkivet bruker KI til blant annet å sortere, lokalisere og tolke dokumenter, samt søke etter bilder. Til slutt oppsummerte hun seminaret med å oppfordre til tverrfaglighet, samarbeid og samtale.
Digital Velferdsstat takker bidragsytere og deltakere for et svært vellykket seminar!